如果只看名字,TencentDB Agent Memory 很容易被理解成又一个“给 Agent 加长期记忆”的项目:保存历史对话,提取用户偏好,再通过向量检索把相关内容放回上下文。
但读完它的 README 和关键代码后,我更愿意把它放在另一个位置:它尝试建设的不是单一记忆库,而是一套 Agent 经验控制面。
官方 README 对问题的定义其实已经很准确:
凡是能让下一个 Agent 少走弯路的信息,都应该被保存、组织并复用。
这句话值得直接保留,不需要为了“原创”而换一种更绕的说法。真正需要继续追问的是:哪些信息可以被当成同一种 Memory?一段用户偏好、一套排障流程、一份设计文档和一个函数调用图,真的适合被切成同一种文本块吗?当这些经验需要在团队中流动时,谁拥有它、哪个版本有效、哪些 Agent 可以使用,又由谁决定?
TencentDB Agent Memory 的回答,是把问题从“怎样检索对话”扩大为:
怎样把 Agent 工作产生的异构经验,转化为可追溯、可装配、可共享、可收回的团队资产。
这也是本文的核心判断:项目的辨识度不在某个局部算法原创,而在于它把数据建模、上下文工程和团队治理放进了同一个闭环。
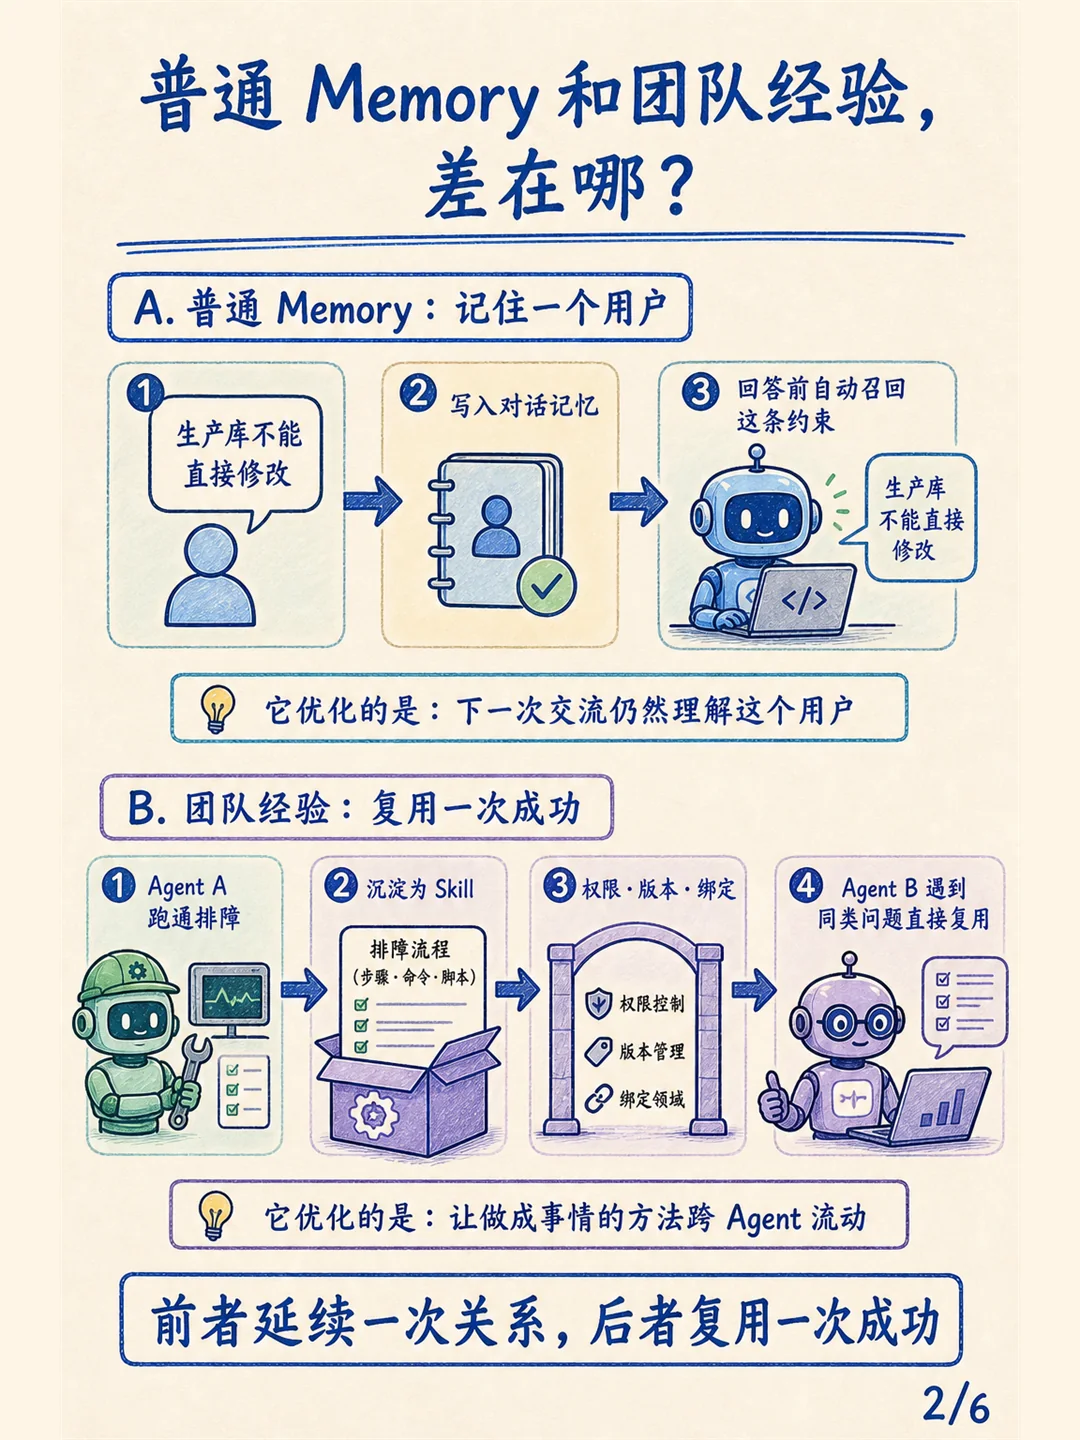
图 1|项目官方技术总览。本文关注的不是图中功能数量,而是四类资产怎样经过治理后进入具体 Agent。
四类资产不是四个菜单,而是一套经验类型系统
项目把经验分成 Chat Memory、Skill、Wiki 和 CodeGraph。README 用真实页面把四类资产解释得很清楚,但代码进一步说明:这不只是产品导航栏的分类,而是一个数据建模决定。
在 MemoryCore/src/metadata/types.ts 中,四者被统一登记为:
type AssetType = "skill" | "llm_wiki" | "code_graph" | "chat_memory";同一个元数据模型还为资产补上 Owner、Version、Visibility、Status、Confidence、Usage Count、Content Ref;FixedAssetBindingEntity 则记录资产绑定给哪个 Agent、采用哪种注入模式以及优先级。
统一发生在治理层,底层表达却没有被强行统一:
| 资产 | 它回答的问题 | 适合的数据结构 | 主要消费方式 |
|---|---|---|---|
| Chat Memory | 这个人是谁,发生过什么,有哪些长期约束 | 原始会话 + 原子事实 + 场景与画像 | 自动召回、稳定背景、按需查原话 |
| Skill | 同类问题以后应该怎样做 | 版本化说明、脚本、模板与资源包 | 固定装配、检索后执行 |
| Wiki | 业务和项目中知道什么 | 页面、章节、链接和全文索引 | 先搜索,再读取页面或关系 |
| CodeGraph | 代码怎样连接,修改会影响哪里 | 文件、符号、调用边和影响路径 | explore、callers、callees、impact |
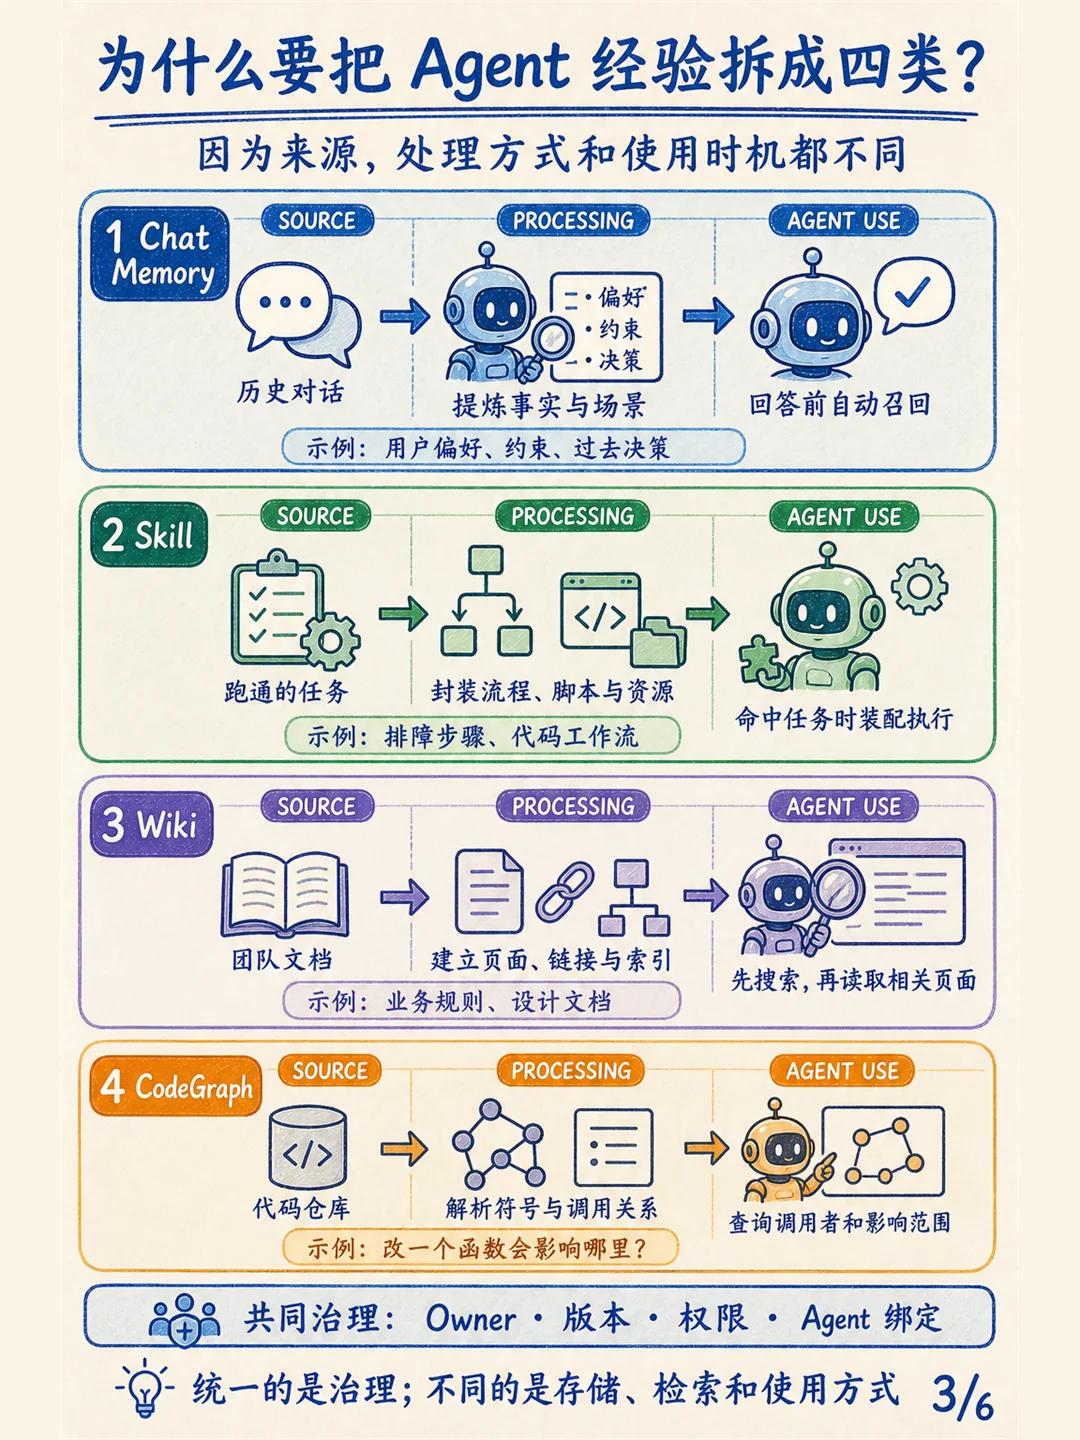
图 2|官方图展示历史交互、任务、文档和代码库进入 Memory Hub。它们共享治理关系,但不共享同一种知识结构。
这个设计为什么合理?因为“经验可以共享”不等于“经验具有同一种语义”。
用户说过“旧鉴权模块不能动”,这是带来源和时间的约束;一次线上事故的排障流程,是有触发边界、执行步骤和验证条件的程序性知识;产品文档需要页面结构与概念链接;代码影响分析则依赖调用图。把它们全部压成向量文本块,确实能获得统一检索接口,却会丢掉使用方式和治理要求。
因此,项目最值得借鉴的第一个原则是:
异构经验可以共享身份和权限,但不必共享同一种存储模型。
代价也来自同一个决定。四种资产意味着多套索引、文件、数据库、构建任务和查询协议;备份、迁移、权限审计和可观测性都会比单一 Memory SDK 更复杂。这里不是“功能越多越好”,而是用系统复杂度换取经验结构不失真。
Chat Memory 的关键不是分成四层,而是同时保留证据与认知
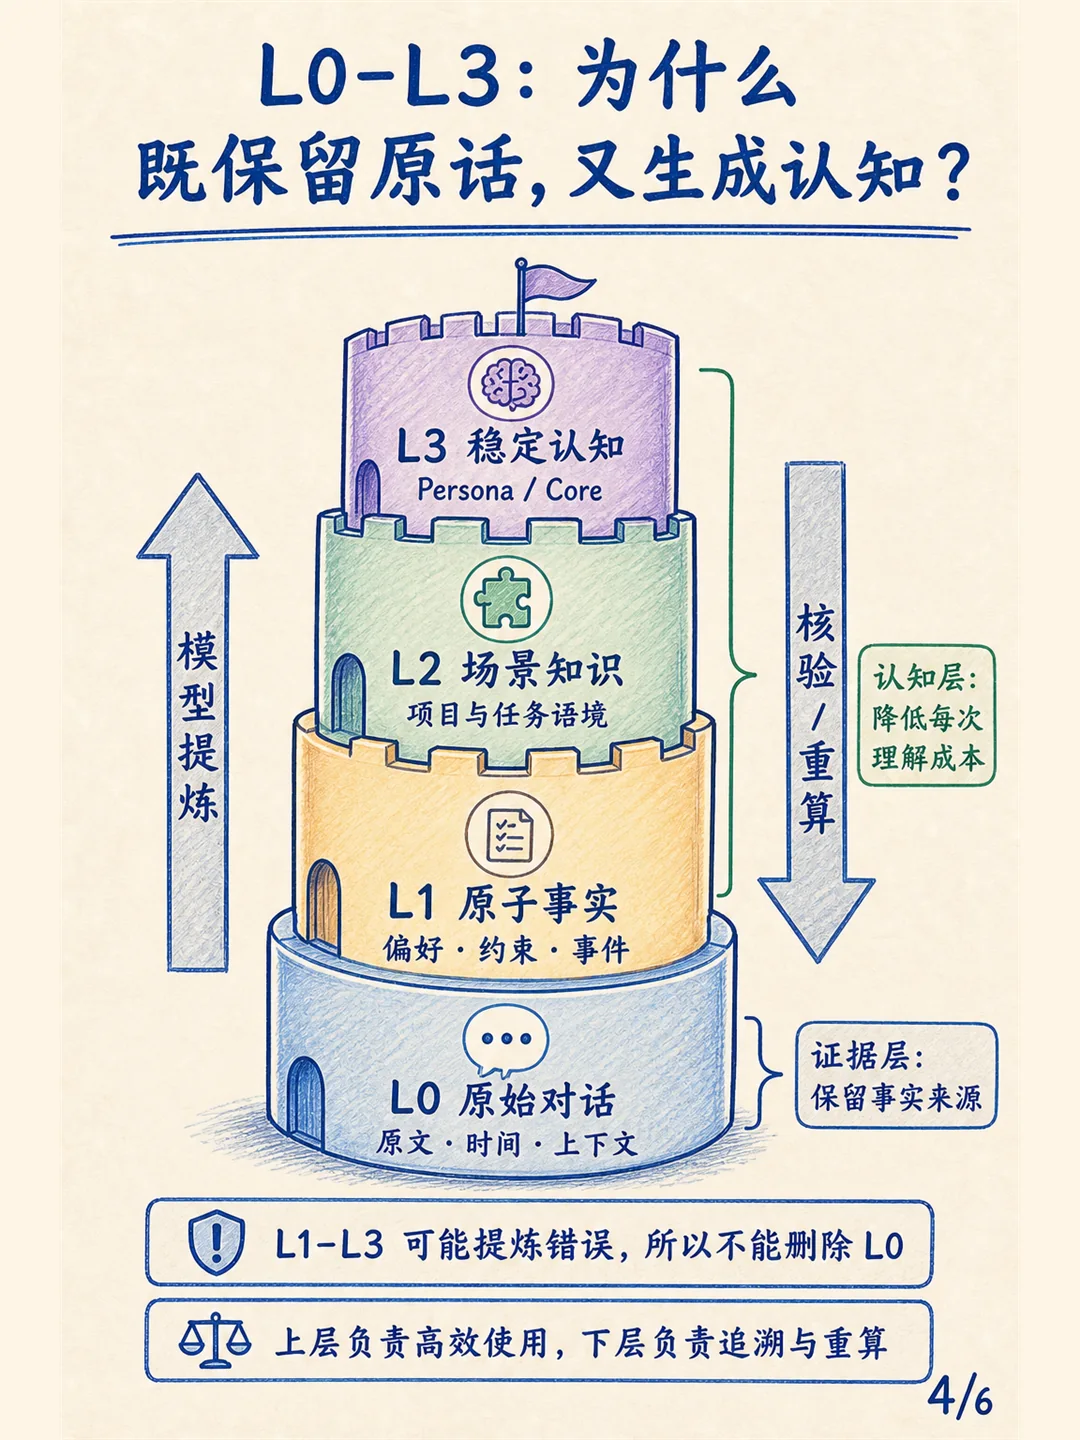
README 将 Chat Memory 表述为 L0 Conversation → L1 Atom → L2 Scenario → L3 Persona:
| 层级 | 系统角色 | 主要用途 |
|---|---|---|
| L0 Conversation | 原始证据 | 核对原话、时间和上下文 |
| L1 Atom | 可检索事实 | 保存偏好、约束、事件和决策 |
| L2 Scenario | 场景知识 | 恢复一个项目或工作场景 |
| L3 Persona / Core | 稳定认知 | 快速进入用户和团队语境 |
图 3|官方页面同时保留 L0-L3。上层认知没有替代底层证据。
这套分层最重要的价值,不是“摘要越来越短”,而是将原始证据与模型派生认知分开保存。
L1-L3 都由模型参与提炼,可能遗漏、误解或过度概括。如果系统只保留最终 Persona,错误摘要就可能变成唯一真相;保留 L0 后,团队至少还可以回到原话核验、在更换模型或 Prompt 后重新加工,并在发现冲突时追踪结论来自哪里。
从代码看,它也不是一个同步调用的摘要函数。MemoryCore/src/utils/pipeline-manager.ts 把不同层级放进独立调度链路:
- L1 在会话达到消息阈值、进入空闲状态或关闭刷新时触发;
- 新会话的 Warm-up 阈值从 1 开始逐次翻倍,先尽快产生可用记忆,再进入稳定批处理;
- L2 同时设置最短间隔、最长间隔和 L1 完成后的延迟,避免每产生一条事实就重算场景;
- L3 使用全局互斥和 pending 去重,避免稳定画像被并发重复生成;
- Service 模式下,
stateful-pipeline-manager.ts把状态、Timer 和 Task Queue 交给外部 Backend 与 Worker。
这是一个典型的工程交换:前台先完成交互和原始记录,后台再逐层提炼;换来更低的在线延迟和更可控的 LLM 调用,付出的则是最终一致性与调度复杂度。
用户刚刚说过的话可能已经进入 L0,但尚未成为 L2/L3。任务失败、队列积压、模型输出变化和重复执行,都需要被观测和恢复。分层本身并不会自动带来可靠记忆,可靠性来自原始证据、Checkpoint、幂等、失败状态和评测共同存在。
从“找到相关内容”到“把合适内容交给 Agent”
多数 Memory 介绍停在检索算法:关键词还是向量,要不要混合搜索。但对于 Agent,检索结果只是中间产物,真正稀缺的是上下文预算。
MemoryCore/src/core/hooks/auto-recall.ts 提供了一个很具体的实现:
- L1 支持 Keyword、Embedding 与 Hybrid 三种策略;
- Hybrid 并行取得关键词和向量候选,再用 RRF 按排名融合;
- 结果受超时、条数、单条字符数和总字符数限制;
- L3 Persona 与 L2 Scene Navigation 被放在稳定、可缓存的 System Context;
- 每轮变化的 L1 召回放在动态 User Prefix,避免频繁破坏稳定 Prompt 缓存;
- 当注入内容不够时,Agent 可以继续调用记忆搜索和原始对话搜索工具,但每轮有调用次数上限。
这可以概括为:
Push 稳定概览,Pull 具体证据。
L2/L3 主动给 Agent 一个低频变化的背景;L1 只召回与当前问题相关的事实;L0 在需要核对原话时再查;Wiki 与 CodeGraph 则通过工具按需展开。
更大的上下文窗口并没有消除这个设计的必要性。上下文越大,输入成本、注意力稀释和冲突信息同时增加。一个 Memory 系统的目标不应是最大化召回量,而应是提高单位上下文预算中的决策价值。
这里同样有边界。RRF 能融合关键词和语义相关性,却不能自动判断哪条相互矛盾的事实在当前时间有效。项目有历史层级和原始证据,但没有像 Graphiti 那样,把事实有效期、失效时间和来源 Episode 建成统一的时序图模型。对于“以前不能上云、现在已经允许”这类变化,仅提高相似度还不够。
Skill 为什么不能只是一段 Prompt
四类资产中,Skill 最能说明“资产化”与“保存内容”的区别。
MemoryCore/src/core/skill/skill-versioning.ts 把一次 Skill 更新编排为:读取当前 Head、校验 Owner 与预期版本、复制旧版本资源目录、应用资源增删、写入新版本;如果数据库写入失败,会清理刚创建的目录;如果正文和资源都没有变化,则幂等返回当前版本。
skill-permission.ts 进一步要求写入者匹配 Team 与 Owner Agent,并使用 expected_version 实现乐观锁,避免协作更新时悄悄覆盖别人的修改。
图 4|官方 Skill 页面展示名称、版本、Owner 与详情。代码中还存在资源目录和历史版本逻辑。
这说明 Skill 的系统语义并不是“可以被检索的一段好 Prompt”,而是:
- 有触发边界的工作方法;
- 有脚本、模板等依赖资源;
- 有明确维护者和版本;
- 可以被审核、共享、装配与回滚;
- 需要验证规则判断执行是否成功。
对团队而言,这很像把个人经验从聊天记录升级为内部软件包。它比向量库中的文本记录更重,但只有补齐这些结构,Skill 才有机会成为可以跨 Agent 复用的程序性知识。
需要保持克制的是:版本化只能证明内容可管理,不能证明方法有效。 Skill 是否真的来自成功任务、是否仍适用于当前代码、脚本是否安全、验证是否充分,还需要独立的评测、审核与失效机制。
经验共享为什么必然走向控制面
当 Memory 只属于一个用户和一个 Bot,“相关就召回”可能已经够用;当资产开始跨成员和 Agent 流动,问题会立即变化:谁是 Owner?团队管理员能不能读个人私密资产?哪个 Agent 可以装配?一个过期 Skill 怎样撤回?
在 MemoryCore/src/metadata/service/permission-checker.ts 中,这些问题被拆成两层:
checkPermission判断用户是否可以读、写、删除、分配、分享或使用资产;canBindAsset判断某个可见性范围的资产能否挂到目标 Agent 上。
Owner、团队成员关系、Visibility、角色默认权限和 User/Role/Agent ACL 依次参与判断。private 在当前代码中是严格私密:即使团队 Admin 也不能读取非本人资产;要共享给团队,需要 Owner 显式改为 team,或通过受限授权开放。
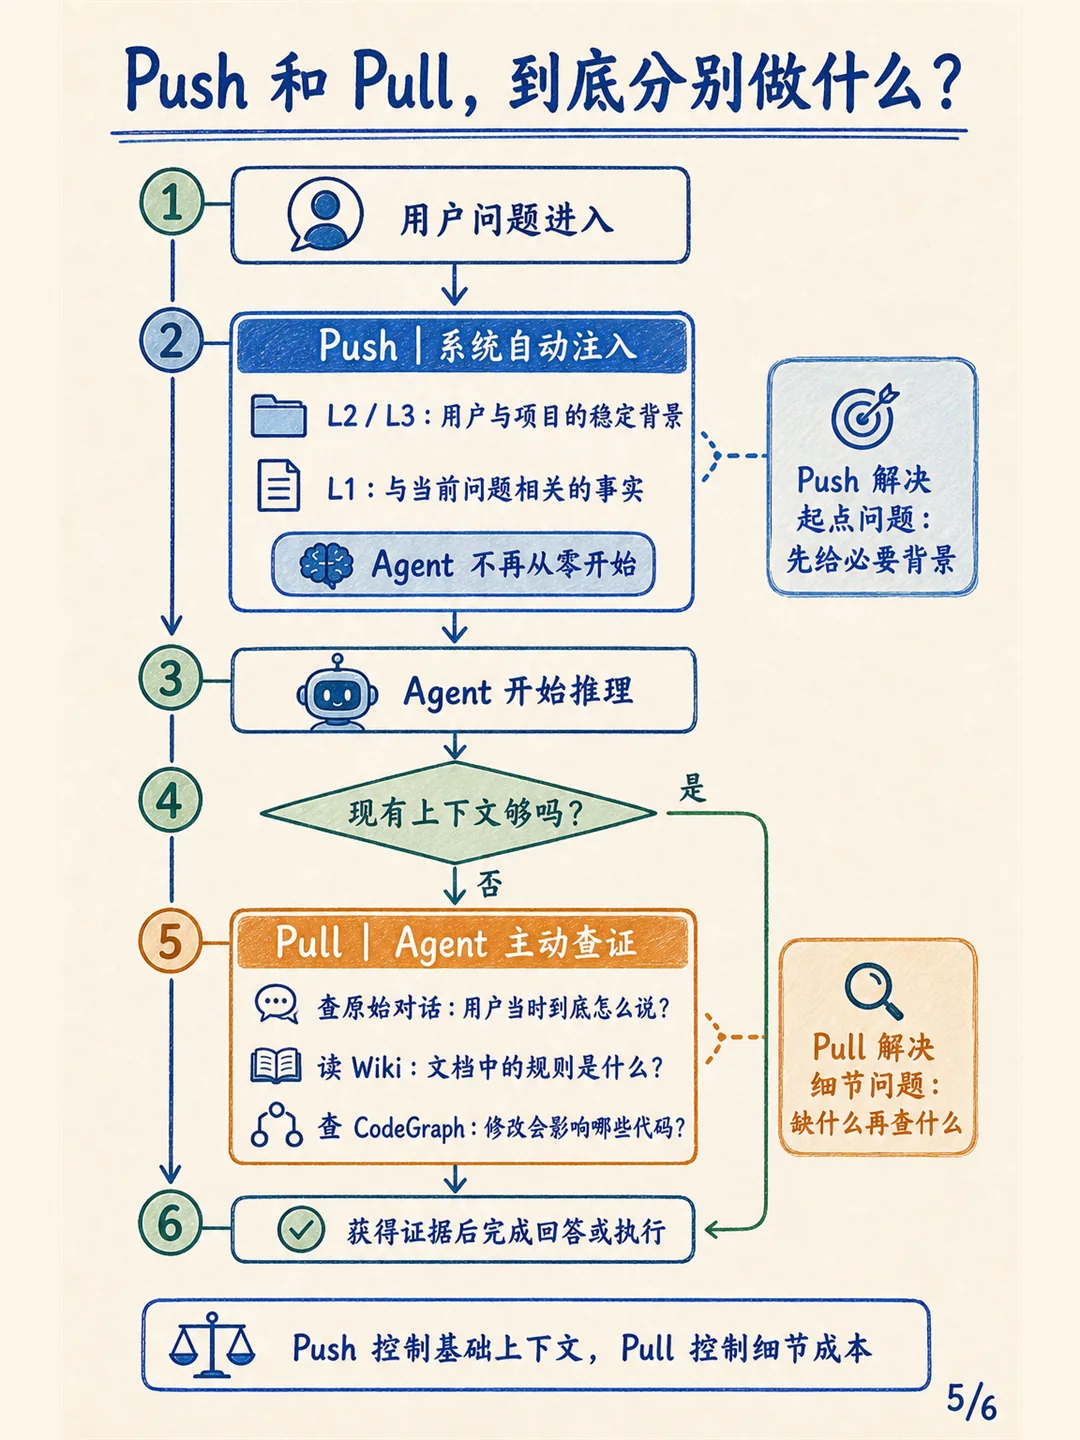
图 5|官方真实页面显示团队资产、Agent 资产和个人资产处在同一个操作界面。它更像控制面,而不是检索结果展示页。
这套设计把两个经常混淆的问题分开了:
- 搜索相关性:当前问题与哪些资产相关?
- 交付资格:即使相关,当前身份和 Agent 是否有权使用?
第二个问题不能交给向量相似度解决。它需要稳定的实体 ID、团队关系、Owner、版本、ACL、固定绑定和审计路径。也正因如此,我认为 TencentDB Agent Memory 的核心产品形态不是 Search API,而是 Memory Hub 所代表的经验控制面。
当前实现仍有现实边界。README 明确说明,人工绑定已经可用,而全自动记忆路由仍在迭代。换句话说,Loadout 的数据模型已经存在,但“系统能否自动选对资产”还不能只靠产品图下结论。对于关键任务,人工装配虽然不够自动,却比不可解释的自动路由更容易审计。
Wiki 与 CodeGraph 为什么选择工具调用,而不是整库注入
文档与代码知识的体量通常远大于对话记忆。TencentDB Agent Memory 没有尝试把整份 Wiki、全仓源码或所有工具说明预装进 Prompt,而是在 MemoryKnowledge/src/routes/tools.ts 中提供两步协议:
/v3/tools/list返回指定知识资产可以做什么;/v3/tools/call调用白名单中的只读工具。
Wiki 提供 search、list_pages、read_page 和 get_graph;CodeGraph 提供 explore、callers、callees、impact、node 与 files 等结构化查询。创建、删除、重建和权限修改没有进入 Agent 的只读白名单。
这里采用的是一种渐进式暴露:Agent 先知道能力边界,只有当前问题真正需要时才展开内容。这样既节省上下文,也缩小了工具权限面。
源码还修正了旧稿中的一个判断。旧分析曾担心 Wiki 与 CodeGraph 共用一条串行 BuildQueue,导致大型仓库阻塞后续小任务;当前 MemoryKnowledge/src/store/build-queue.ts 实际采用 per-asset-key queue:同一资产的构建串行,避免 Git、SQLite 与文件互相覆盖;不同资产拥有各自的队列,可以并行推进。
这不意味着构建吞吐已经没有问题。不同资产仍会争用 CPU、磁盘和 LLM 配额,团队级公平调度、取消、限流与容量模型仍值得继续追问。但代码证据至少说明,不能再把“全局串行队列”当成当前缺陷。
Proxy 让增强层可以接入,也必须让它可以失败
项目支持 SDK、OpenClaw、Hermes、Claude Code、CodeBuddy 等入口。这里的关键不只是适配数量,而是 Memory 如何进入一个原本不认识它的 Agent。
MemoryProxy/src/handler.ts 在模型请求前解析会话身份并运行 Injection Pipeline,在响应完成后把对话回写为 L0,同时触发 Skill Conversation Add。对于流式响应,L0 写入不会阻塞 SSE 关闭,而是进入带重试和优雅关停追踪的异步写路径。
更重要的是,注入 Pipeline 抛错时,代码选择回退到原始请求继续访问上游模型:
Memory 是增强层,不应该因为一次召回或注入故障,让 Agent 的主任务完全不可用。
这是独立 Proxy 存在的合理理由之一。它把模型协议、身份绑定、资产注入和结果回流从具体 Agent 应用中抽离出来,接入方不必重复实现。
代价是复杂度被集中到了平台层。Proxy 同时承担协议转换、身份、缓存、注入、写回、模型路由、限流、成本和观测后,就会成为需要高可用、超时、熔断、追踪与端到端测试的关键组件。项目减少了每个 Agent 的接入代码,却没有消灭复杂度,只是把复杂度放到了更适合统一治理的位置。
竞品比较:它们解决的不是同一层问题
把 Memory 项目做成功能打勾表,很容易得到误导性的“谁更全面”。更公平的方式,是先看各自选择了什么主抽象。
| 项目 | 首要抽象 | 更强的地方 | TencentDB Agent Memory 的相对位置 |
|---|---|---|---|
| Mem0 | 通用 Agent Memory Layer | 接入轻、生态和公开记忆评测更成熟;聚焦用户、会话和 Agent 记忆 | 四类经验与团队治理覆盖更广,但轻量接入和公开评测不占优势 |
| Graphiti | Temporal Context Graph | 事实有效期、来源 Episode、增量图更新与历史查询更专门 | Skill、Wiki、CodeGraph 与 Loadout 更完整,但时间和冲突模型更弱 |
| Letta | Stateful Agent Platform | Memory Blocks 与 Agent 运行时深度结合,Agent 自主管理长期状态 | 资产层更适合服务多个外部 Agent,但对单个有状态 Agent 的运行时控制不如 Letta 深 |
| TencentDB Agent Memory | Team Experience Asset Platform | 四类资产、Owner、版本、ACL、绑定、Proxy 和工具交付形成闭环 | 覆盖面较广,同时也是更重、更需要工程治理的一类方案 |
以上比较基于各项目官方仓库截至 2026-08-09 的公开定位,不等同于统一 Benchmark。
如果只要求一个应用快速记住用户偏好,Mem0 更直接;如果核心问题是事实随时间变化,Graphiti 的双时间和来源建模更值得优先研究;如果希望 Agent 自己管理持续可见的内部状态,Letta 与运行时结合得更深。
TencentDB Agent Memory 的差异,是把问题扩大到了“团队经验如何形成、治理和交付”。这让它没有必要宣称“比所有 Memory 项目记得更准”。更可信的定位是:
它在尝试建立一个跨 Agent 的经验资产层。
项目的优势,恰好也是它需要付出的成本
我认为它目前最强的五点是:
- 经验抽象完整。 它没有用 Chat Memory 代替 Skill,也没有用 Wiki 代替 CodeGraph。
- 原始证据与派生认知共存。 L0 让模型生成的上层记忆仍有核验和重算入口。
- 上下文交付有层次。 稳定概览、动态召回、原始对话和知识工具采用不同进入方式。
- 团队治理是第一等能力。 Owner、版本、Visibility、ACL 和 Agent Binding 不是事后补丁。
- 接入与资产相对解耦。 SDK、Proxy 与多框架适配允许记忆资产服务不同 Agent。
但每一点都带着对应成本:
- 异构资产提高表达能力,也增加多服务、多存储和迁移复杂度;
- 异步提炼降低在线延迟,也带来最终一致性、重试和积压问题;
- 分层上下文减少噪声,也需要持续调校预算、阈值和失效策略;
- 团队治理降低误共享风险,也增加身份、权限和审计面的实现责任;
- Proxy 降低接入方改造,也把大量复杂度集中到平台关键路径。
工程证据也提醒我们保持克制。当前分支的 .github/workflows/pr-ci.yml 只执行安装、打包、Manifest、包体积和 Skill Queue Isolation Guard,没有执行 build、typecheck 或 test;仓库虽然包含 Vitest 配置和测试脚本,但这个提交没有公开的 *.test.*、*.spec.*、tests/ 或 __tests__/ 源码。
这不等于代码一定不可靠,却意味着外部使用者目前无法通过公开测试证据验证许多关键行为。对于一个同时处理权限、异步 Pipeline、版本与多协议代理的项目,测试和 CI 不是“完善文档之后再补”的外围工作,而是产品可信度的一部分。
README 报告 PersonaMem 从 48% 提升到 76%,相对提升 59%。本文保留这个官方结果,但不把它写成独立验证结论,因为当前仓库未找到对应数据集、运行脚本、模型、Prompt、成本与原始日志。真正有说服力的下一步,是公开分层消融:提升究竟来自 L1 检索、L2/L3 注入、Persona、Scene Navigation,还是更大的输入预算?
谁值得采用,谁应该选择更轻的方案
这套架构更适合以下场景:
- 多个 Agent 或团队成员需要共享长期经验;
- 同时存在用户记忆、工作方法、业务文档和代码知识;
- 需要明确 Owner、版本、权限、审核和定向装配;
- 已有大量历史 Session、文档与代码库,希望缩短新 Agent 冷启动;
- 能够维护 Core、Knowledge、Panel、Proxy 及相应存储与 LLM 依赖;
- 愿意先在可信内网或 POC 中评测召回质量、成本和故障恢复。
以下情况则大概率过重:
- 只有一个 Bot,只保存少量偏好和历史事实;
- 团队优先追求几行代码完成接入;
- 不需要 Skill、Wiki、CodeGraph、ACL 和 Agent Loadout;
- 无法接受异步构建和最终一致性;
- 对生产 SLO、可复现 Benchmark 和完整测试证据有立即要求。
判断标准不是“功能够不够多”,而是你的问题是否已经从个性化记忆升级为团队经验治理。如果没有,轻量 Memory Layer 往往更合适;如果已经出现经验共享、版本冲突、角色装配和隐私边界,控制面复杂度就不再是多余设计,而是迟早要支付的成本。
可以从这个项目带走的七条设计原则
即使最终不采用 TencentDB Agent Memory,这个仓库仍提供了几条可迁移的工程原则:
- 先区分经验语义,再选择存储和检索。 不要默认所有知识都是文本块。
- 保留原始证据,把模型输出视为可重算的派生数据。 摘要不应成为唯一真相。
- 在线交互与后台提炼解耦。 让价值尽快出现,但把最终一致性明确暴露出来。
- 检索与上下文交付是两个问题。 找到相关内容之后,还要决定何时、以什么粒度进入 Prompt。
- Push 概览,Pull 细节。 稳定背景适合缓存,昂贵证据适合按需读取。
- 经验一旦共享,就必须带上 Owner、版本、权限和装配关系。 相关性不能替代授权。
- 增强层必须允许失败开放。 Memory 故障不应轻易拖垮 Agent 主执行链路。
结论:它把 Memory 从模型能力问题变成了系统设计问题
TencentDB Agent Memory 使用的许多局部机制并不新:BM25、向量检索、RRF、ACL、版本控制、知识图和协议代理都有成熟先例。项目真正有辨识度的地方,是把这些机制放在一条完整的经验链路中:
原始证据 → 分层认知 → 异构资产 → 权限治理 → 上下文交付 → 使用结果回流
从这个角度看,它不是在回答“怎样让模型记住更多”,而是在回答一个更难、也更接近团队真实使用的问题:
怎样让正确的经验,以正确的形态,在正确的权限下,被正确的 Agent 复用。
这套设计在多 Agent 团队中有明确价值,也确实比轻量记忆层更重。它目前最值得肯定的是产品抽象与系统边界;最需要补齐的是可复现评测、自动路由解释、时间冲突模型以及公开测试和 CI。
我的最终判断是:这是一个值得研究、适合 POC、但还需要用工程证据继续验证生产成熟度的项目。它提供的最大收获,不是一套“最强记忆算法”,而是一种从个人上下文走向团队经验资产的系统路径。
Sources
Project
- TencentDB Agent Memory 官方仓库
- feat/server_team 中文 README
- 本文分析提交:
fe3230f176f1bf5832fee79d12494bbc2d19a8aa - 关键源码:
MemoryCore/src/metadata/types.ts - 关键源码:
MemoryCore/src/utils/pipeline-manager.ts - 关键源码:
MemoryCore/src/core/hooks/auto-recall.ts - 关键源码:
MemoryCore/src/core/skill/skill-versioning.ts - 关键源码:
MemoryCore/src/metadata/service/permission-checker.ts - 关键源码:
MemoryKnowledge/src/routes/tools.ts - 关键源码:
MemoryKnowledge/src/store/build-queue.ts - 关键源码:
MemoryProxy/src/handler.ts
Competitors
- Mem0 官方仓库,访问日期 2026-08-09
- Graphiti 官方仓库,访问日期 2026-08-09
- Letta 官方仓库,访问日期 2026-08-09
Method note
本文复用了 README 中准确的项目定义、资产名称、官方图表和已明确标注的产品状态;文章的中心判断、因果关系、代码解释、竞品坐标和适用边界由源码与交叉证据重新组织。未运行完整系统或复现 Benchmark,因此不把静态代码分析写成运行性能结论。